Este é o segundo artigo de uma série de quatro artigos sobre como processar câmeras grande-angular para auxiliar a estacionar um carro elétrico.
No primeiro post, quatro câmeras viraram uma vista de cima do veículo. Para o motorista ela basta: ele olha e entende. Mas para um sistema de estacionamento autônomo a imagem não é suficiente. Ele precisa saber, ponto a ponto, o que há em volta: onde o chão está livre, onde estão as faixas da vaga e onde há um obstáculo — e a que distância.
Neste post, ensinamos um modelo de inteligência artificial a responder isso a partir das imagens das câmeras e usamos a mesma projeção do primeiro post para montar um mapa de ocupação.
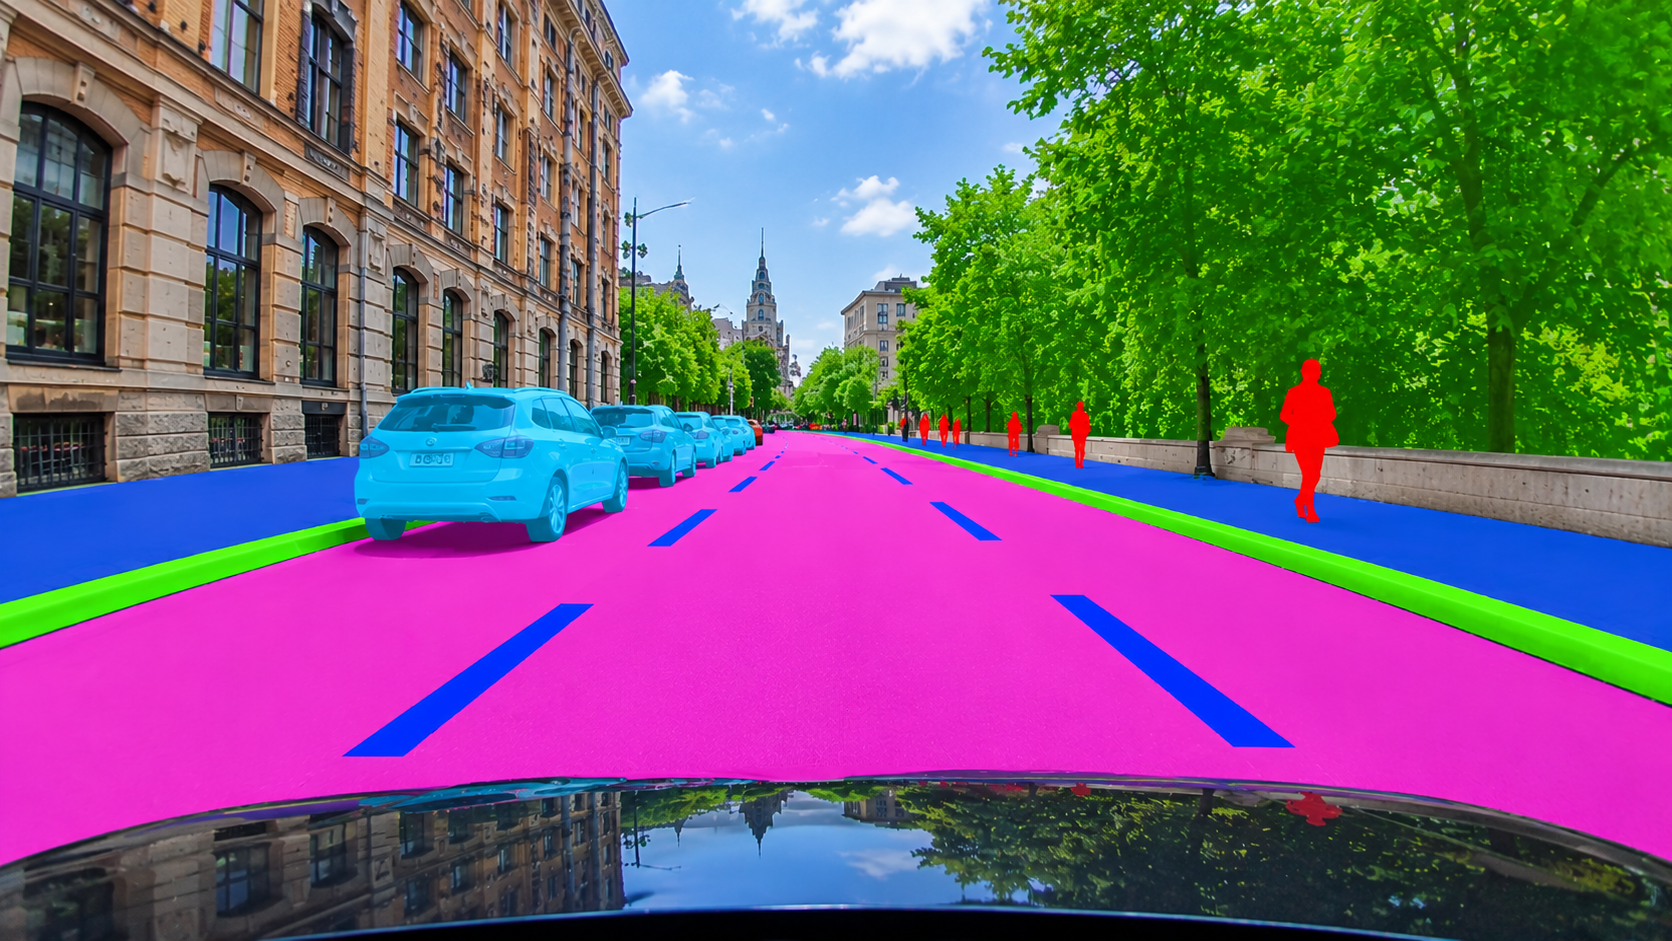
Pintar cada pixel: segmentação
A tarefa se chama segmentação semântica: para cada pixel da imagem, dizer o que ele é (qual a “classe”). O resultado é chamado de máscara de segmentação. Para estacionar, há algumas classes essenciais: rua (chão por onde se pode andar), faixa pintada e, por exclusão, todo o resto, que conta como obstáculo.
Não existe fórmula que separe rua de calçada só pela cor do pixel; o que existe é aprendizado de máquina. Um modelo vê milhares de imagens junto com a anotação — uma máscara pintada à mão por uma pessoa que representa a resposta certa esperada — e vai ajustando seus parâmetros até acertar.
Três conjuntos de dados
Anotar imagens pixel a pixel é caro, então se começa por conjuntos públicos quando possível. Três foram relevantes aqui:
Cityscapes: 5.000 fotos de ruas de cidades alemãs, tiradas do para-brisa, anotadas com muito detalhe em 19 classes (rua, calçada, carro, pessoa, poste…). Não tem classe para faixa pintada.
BDD100K: 100.000 quadros de câmeras de painel em ruas dos Estados Unidos. As anotações que interessam são justamente as duas de que precisamos: área por onde se pode dirigir e faixas pintadas.
WoodScape: imagens reais de carros com quatro câmeras olho-de-peixe, frente, trás e laterais, montadas como as nossas. Cerca de 8.000 imagens anotadas, com rua, faixa, meio-fio, pessoas e veículos.
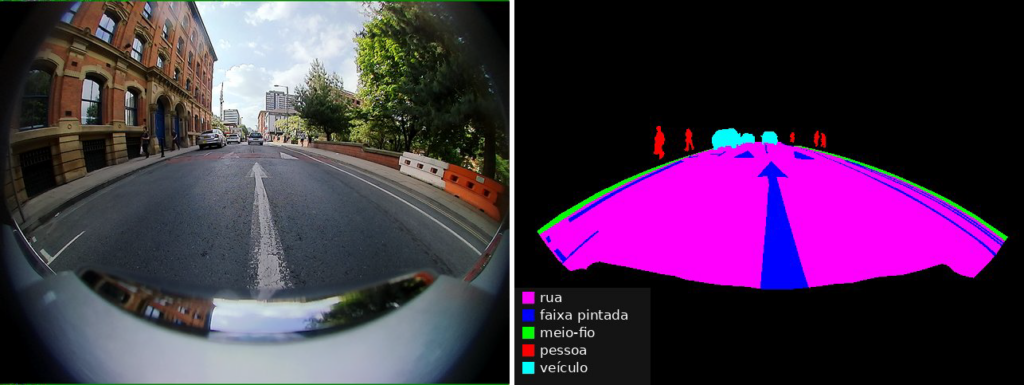
Câmera da frente do WoodScape e sua anotação. Imagem: Valeo WoodScape Dataset.
A diferença que importa: Cityscapes e BDD100K são câmeras comuns olhando para a frente (“dashcam”). Só o WoodScape vê o mundo como as nossas câmeras veem, curvado e de cima, com as laterais olhando quase para baixo. A contrapartida é a licença: o WoodScape é só para pesquisa, e nenhum modelo treinado com ele pode conduzir um veículo nem ajudar alguém a conduzir. Por isso ele serve para decidir o método, que depois será repetido com imagens nossas.
Os modelos
Testamos quatro modelos, todos leves o bastante para rodar em tempo real num computador de bordo: YOLOP e TwinLiteNet+, que vêm prontos do BDD100K (rua e faixas), e PIDNet e DDRNet, que vêm do Cityscapes.
“Vir pronto” quer dizer pré-treinado: os autores publicam o modelo já treinado no seu conjunto de dados. A partir dele, pode-se fazer um ajuste fino (fine-tuning): continuar o treinamento com imagens do nosso tipo, para que o modelo se adapte a elas sem começar do zero.
Os treinamentos
Os quatro modelos foram ajustados com o WoodScape. Depois do ajuste fino, ficaram praticamente empatados: treinar com imagens das nossas câmeras importa bem mais do que qual modelo se escolhe. Seguimos com o YOLOP e treinamos com 100, 500 e todas as 6.065 imagens, para analizar como o resultado muda de acordo com a quantidade usada. Utilizamos aumentação de dados: cada imagem é mostrada em muitas versões levemente alteradas para não “viciar” o modelo nas imagens vistas. Comparamos os modelos através de métricas quantitativas específicas, mas também comparando qualitativamente alguns resutlados, como mostrado abaixo.
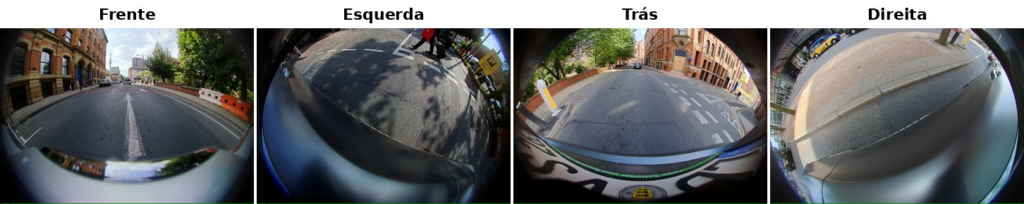
As quatro câmeras de um carro do WoodScape.
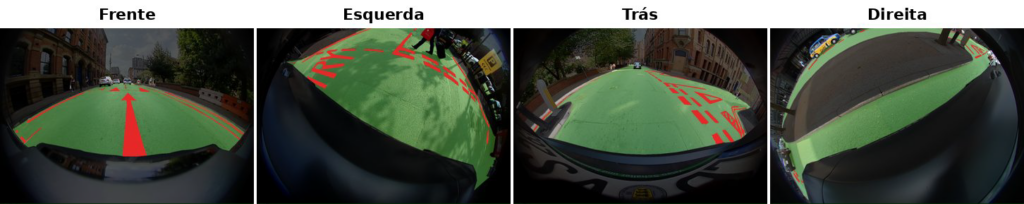
A resposta certa, pintada à mão por um humano: verde é rua, vermelho é faixa.
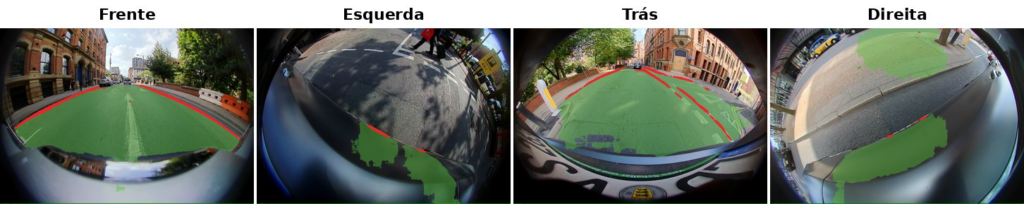
O resultado do YOLOP pré-treinado, sem ajuste fino, com vários erros. Os piores resultados são nas câmeras laterais, o que é condizente, já que modelo original foi treinado em “dash-cam” (frontal) apenas.
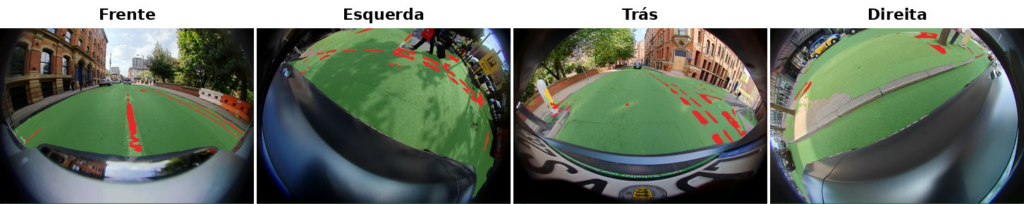
Fazendo fine-tuning em 100 imagens, o resultado já começa a melhorar.
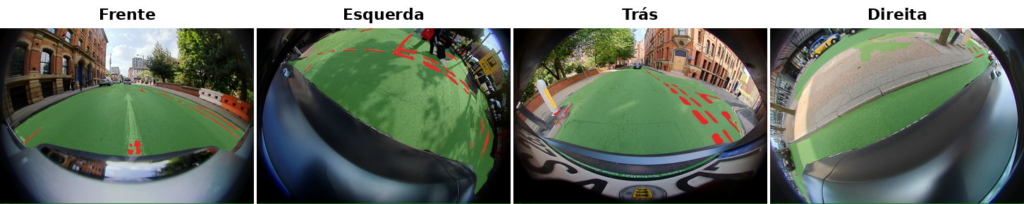
Fazendo fine-tuning em 500 imagens, melhorou em alguns pontos mas piorou em outros.
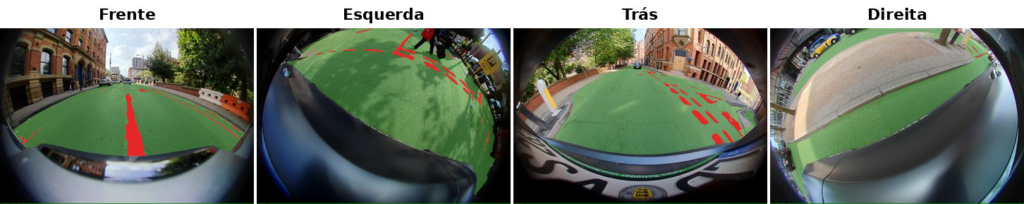
Fazendo fine-tuning com todas as 6.065 imagens o resultado fica muito bom.
Como um trabalho futuro, podemos experimentar técnicas de “few-shot learning” que visam melhorar resultados de
fine-tuning com poucas imagens, para conseguir bons resultados com algumas centenas ao invés de precisar de milhares de imagens.
Do pixel ao mapa de ocupação
As máscaras passam pela mesma projeção do primeiro post e são costuradas do mesmo jeito. O resultado é o mapa de ocupação: uma grade de quadradinhos de 5 cm em volta do veículo, cada um livre, faixa (pintada, mas transitável), ocupado ou desconhecido (nenhuma câmera vê).
Para testar a cadeia inteira, rodamos o modelo treinado com 100 imagens do WoodScape nas câmeras da nossa cena sintética. Como a cena é nossa, temos também as máscaras perfeitas, e dá para comparar os dois mapas:
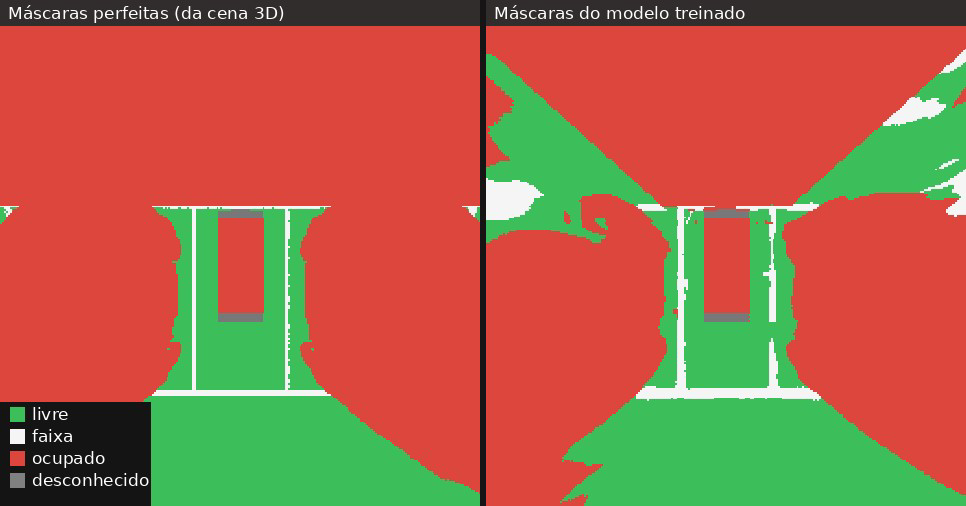
O veículo é o retângulo no centro, de frente para a calçada (em cima). À esquerda, o mapa com as máscaras perfeitas; à direita, com as do modelo.
Câmeras não bastam: os sonares
Mesmo com um modelo melhor, uma câmera pode falhar sem avisar: contraluz, sujeira na lente, um chão que a IA nunca viu. E o meio-fio, baixo e contínuo, é exatamente o obstáculo mais difícil para ela. Por isso os sistemas de estacionamento reais não dependem só de câmeras: complementam com sonares, os sensores de ultrassom do para-choque, os mesmos que apitam quando o carro se aproxima de uma parede. Eles medem a distância até o obstáculo mais próximo por eco, sem depender de luz nem de IA. Simulá-los e somá-los ao mapa de ocupação está nos planos do projeto.
Valeo WoodScape Dataset: github.com/valeoai/WoodScape. Cityscapes: cityscapes-dataset.com.
BDD100K: bdd-data.berkeley.edu.