Este é o terceiro artigo de uma série de quatro artigos sobre como processar câmeras grande-angular para auxiliar a estacionar um carro elétrico.
Nos posts anteriores, quatro câmeras viraram uma vista de cima e uma inteligência artificial aprendeu a separar rua, faixa e obstáculo. Este post conta por que dados sintéticos foram utilizados, e como.
Por que simular
Ao começar um projeto de visão computacional, raramente se tem tudo à mão e esperar pode atrasar o projeto. Dados sintéticos — imagens geradas por computador em vez de fotografadas — podem possibilitar realizar grande parte do desenvolvimento, e possuem algumas vantagens:
- Experimentar antes de montar. Mudar a altura ou a inclinação de uma câmera, trocar a lente ou o tamanho do padrão de calibração custa um novo render, não um dia na oficina. Foi assim que escolhemos pôr as câmeras sob o teto, a 1,58 m e inclinadas 45°.
- A resposta certa precisamente. Numa cena criada por nós, sabemos exatamente onde está cada objeto, a posição de cada câmera e o que é cada pixel. É isso que permitiu dizer que a calibração erra 1,4 cm a 5 m, ou que o mapa de ocupação acerta 92 % do chão: medir de forma precisa.
- Rotular sem pintar à mão. No post anterior, cada imagem de treino precisava ser pintada pixel a pixel por uma pessoa. Na simulação, essa anotação sai pronta, junto com a imagem.
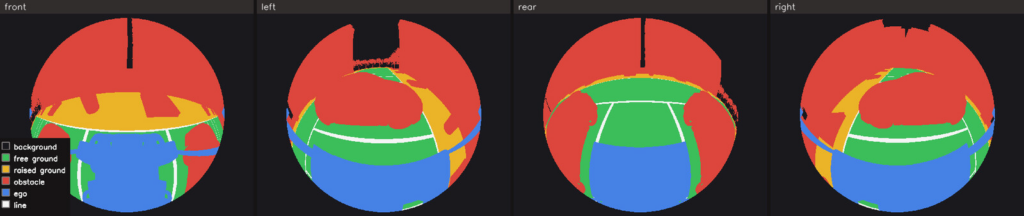
As máscaras das quatro câmeras, geradas pela própria cena: verde é chão livre, amarelo é calçada e meio-fio, vermelho é obstáculo, azul é o próprio veículo.
O limite também precisa ser dito: um modelo que só viu imagens sintéticas pode se enganar nas reais, com ruído, reflexos e sujeira que a simulação não tem. Os pesquisadores chamam isso de diferença entre simulação e realidade (sim-to-real gap). Por isso a simulação acelera e orienta o trabalho, mas imagens reais ainda vão ser necessárias e essenciais.
Dois caminhos para gerar imagens
Modelar o mundo em 3D
O caminho clássico é o dos filmes de animação e dos jogos: construir a cena em 3D — chão, carros, árvores, prédios, luz — e renderizar, isto é, calcular a imagem que uma câmera veria, simulando como a luz bate em cada superfície. As quatro câmeras veem exatamente a mesma árvore, a lente olho-de-peixe é reproduzida com precisão, e as anotações saem perfeitamente alinhadas com a imagem.
O custo é o trabalho: um mundo convincente precisa de muitos modelos, texturas e uma iluminação cuidada. Sem isso, as imagens ficam com cara de videogame.
Pedir a uma IA generativa
O caminho novo são os modelos de IA generativa de imagens, como o Stable Diffusion XL (SDXL), que criam fotos realistas a partir de uma descrição em texto.
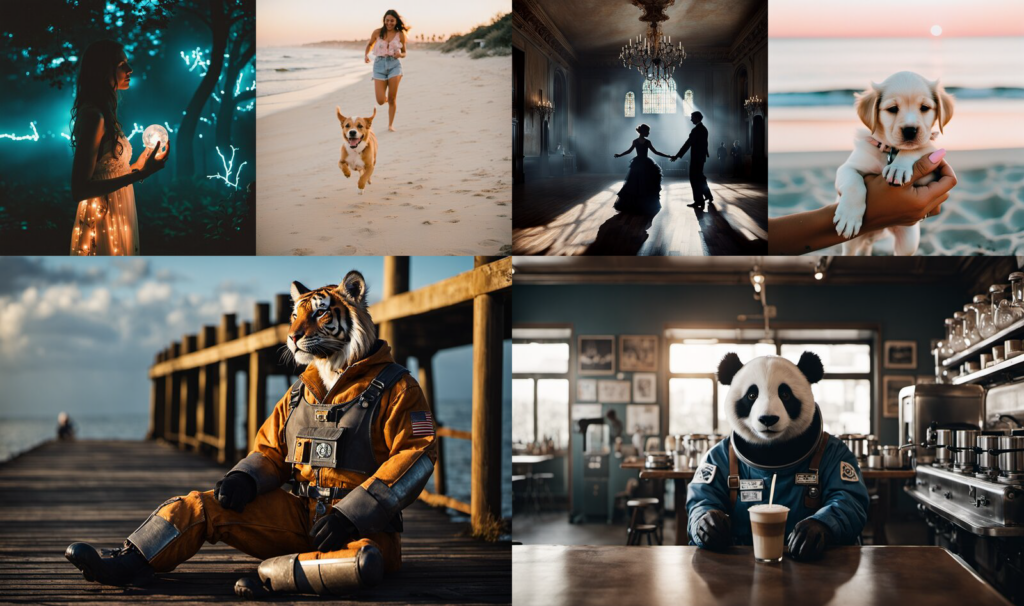
Exemplos do SDXL, gerados só a partir de texto. Imagem: Stability AI, página oficial do modelo.
Só texto não basta para nós: precisamos que a vaga, o meio-fio e os carros estejam em lugares exatos. Para isso existem técnicas como o ControlNet, que guiam a geração por um mapa — por exemplo, uma máscara de segmentação: “aqui é céu, aqui é casa, aqui é grama”. A IA preenche cada região com aparência realista.
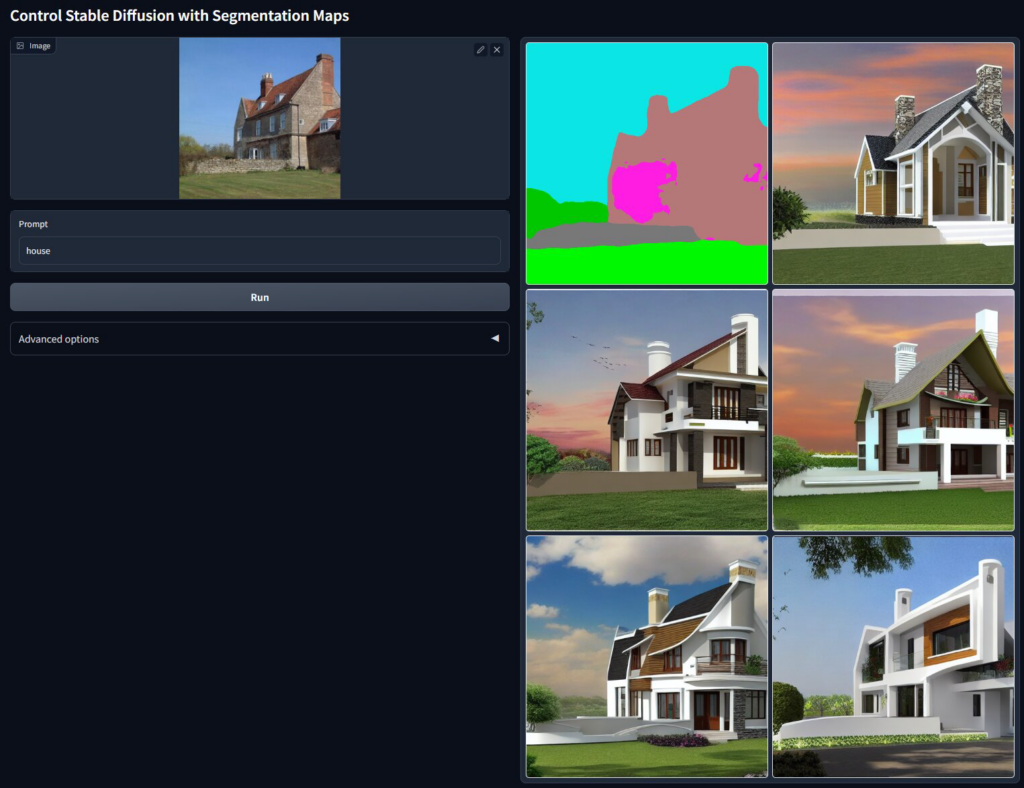
A partir de uma foto, extrai-se uma máscara (em cima, à esquerda); a IA gera casas novas que respeitam aquela máscara. Imagem: repositório oficial do ControlNet.
Repare que cada geração produz uma casa diferente. Para arte, isso é uma qualidade; para nós, é o principal problema. Os desafios no nosso caso:
- Consistência entre as quatro câmeras. Gerada separadamente para cada câmera, a mesma árvore pode sair diferente em cada uma — e a costura da vista de cima denunciaria na hora.
- A lente olho-de-peixe. Esses modelos aprenderam com fotos comuns. Na borda curvada de uma imagem olho-de-peixe, tendem a deformar ou inventar detalhes.
- Fidelidade à resposta certa. Se a IA desloca o meio-fio alguns pixels ou inventa uma árvore, a máscara deixa de ser a resposta certa — e a vantagem de rotular de graça se perde.
Há caminhos para contornar isso. Modelos feitos para direção, como o NVIDIA Cosmos, geram as várias câmeras de um veículo juntas, algumas versões até com quatro olhos-de-peixe; mas foram treinados para um conjunto específico de câmeras, e adaptá-los ao nosso exige bastante trabalho e computação. Outra saída é usar a IA não para a imagem final, mas para criar peças da cena 3D — modelos de árvores, texturas de calçada — que depois são renderizadas normalmente.
Nossa escolha: 3D, com ajuda de IA
Ficamos com o caminho 3D, porque para medir precisamos que a geometria e as anotações sejam exatas. A IA entrou onde ajuda sem pôr isso em risco:
- Modelos prontos e gratuitos. Árvore com canteiro, lixeira, prédios e o carro vizinho vieram da biblioteca gratuita BlenderKit; o nosso veículo é um modelo próprio do projeto.
- A cena escrita por IA. Em vez de montar tudo à mão no Blender, a cena é gerada por scripts escritos com o Claude, um assistente de IA para programação: onde fica cada vaga, cada carro, cada árvore, a posição do sol, as câmeras, os renders e as máscaras. Assim a cena inteira pode ser refeita de um comando, e uma mudança (uma lixeira maior, uma rua mais longa) é uma linha de código, não uma tarde de cliques.
- Texturas complementares geradas por IA. As texturas do asfalto e da calçada de pedra portuguesa foram criadas com IA generativa, justamente onde ela é segura: uma imagem de chão repetida não precisa ser consistente entre câmeras, porque o próprio render 3D garante isso.
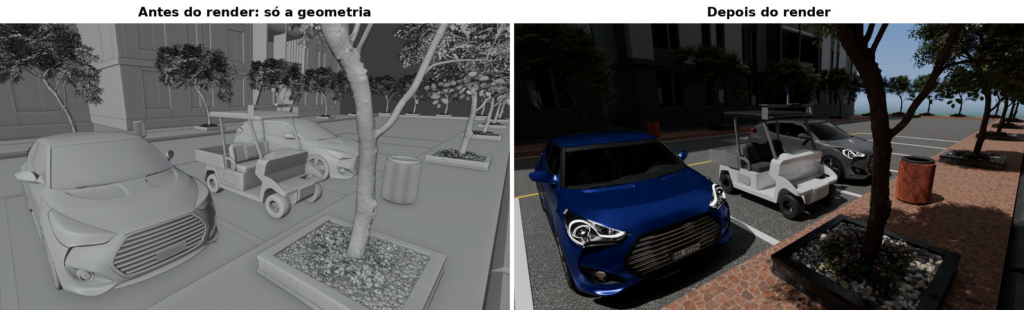
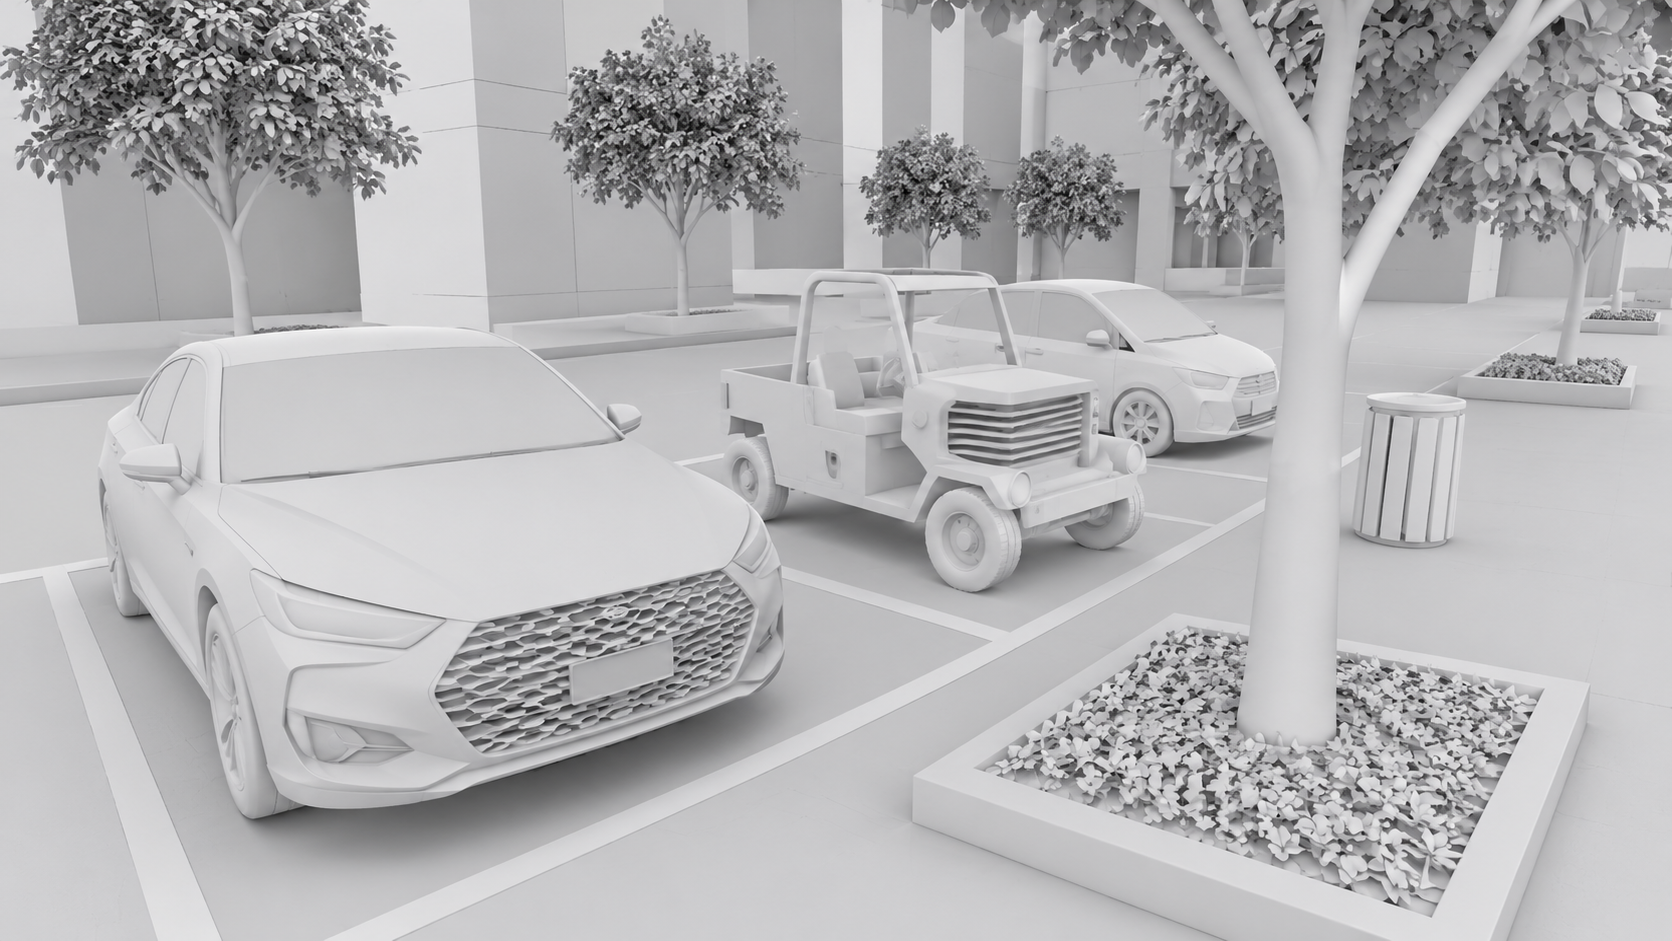
À esquerda, a cena como aparece no Blender enquanto é montada: só formas, sem cor nem luz. À direita, o render final, com texturas, sol e sombras.
O resultado não é perfeito — ainda dá para perceber que é uma simulação —, mas é bom o bastante para o que precisamos: desenvolver, comparar alternativas e medir o erro de cada etapa. Quando as câmeras reais chegarem, a mesma cadeia vai rodar sobre elas, e a cena sintética continua como a régua contra a qual tudo é comparado.
Imagem do SDXL: Stability AI, stable-difiusion-xl-base-1.0 (licença CreativeML Open RAIL++-M).
Imagem do ControlNet: lllyasviel/ControlNet (licença Apache 2.0). Modelos 3D: BlenderKit.